RAGとは?意味・仕組みとLLMOでチャンク設計が重要な理由
RAGとは何か?わかりやすく仕組みを解説
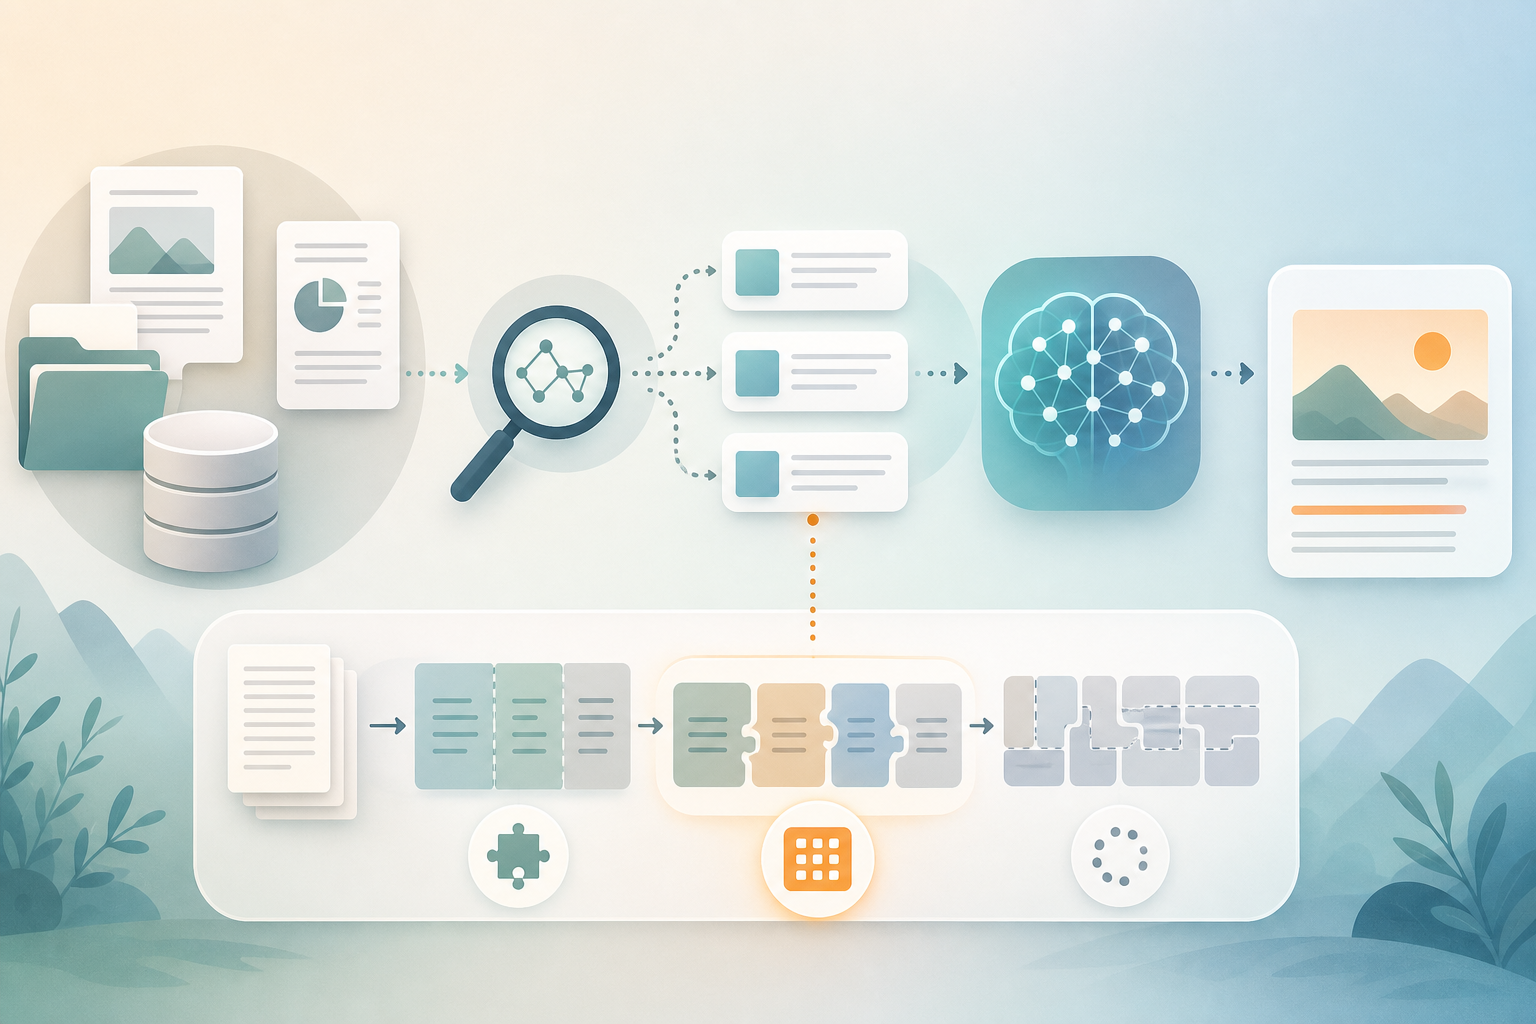
RAGとは「Retrieval-Augmented Generation」の略で、日本語では「検索拡張生成」または「取得拡張生成」と訳される仕組みである(出典: qiita.com)。大規模言語モデルが回答を生成する際に外部データベースやドキュメントから関連情報を検索し、その内容を参照しながら回答を組み立てる。処理は「検索(Retrieval)」「拡張(Augmentation)」「生成(Generation)」の3フェーズで構成され、検索フェーズで得た情報をプロンプトとの関連性に基づいてランキングし、上位の情報を生成フェーズに渡す(出典: ntt.com)。
具体的には、質問文をベクトル化し、あらかじめ分割・格納された文書データ(チャンク)の中から意味的に近いものを取得する。RAGは「学習済みの知識のみで回答する先生」ではなく「必要に応じて参考書や資料を確認しながら回答する先生」に例えられる仕組みであり(出典: helpfeel.com)、モデル自体の学習データに依存せず最新情報や社内固有の情報を回答に反映できる点が特徴である。ChatGPTやPerplexityなどのAI検索サービスの多くも、この仕組みを応用して外部情報を引用している。
RAGはなぜ必要とされているのか?
RAGが必要とされる理由は、従来のLLM単体では知識が学習時点で固定され、事実と異なる内容を生成する「ハルシネーション」が起きやすいためである。従来のLLMの知識を更新するにはファインチューニング(追加学習)やトランスファーラーニング(転移学習)が必要だが、RAGはリアルタイムで外部情報を取得し最新情報を反映できる(出典: ntt.com)。
また、企業独自の社内マニュアルや価格情報など、モデルの学習データに含まれていない情報を扱う場合にもRAGは有効である。質問時に関連情報を同時に提供することで、追加学習のステップを省略しながら独自情報を踏まえた回答を可能にする(出典: hitachi-solutions.co.jp)。回答の根拠となった文書を提示できるため、情報源の透明性を確保しやすい点も、従来の生成AIにはない利点として挙げられる。
RAGとファインチューニングの違いは?
RAGとファインチューニングの違いは、情報をモデルに反映させる方法にある。ファインチューニングはモデル自体の重みを追加学習で書き換えて知識を内部に組み込む手法であるのに対し、RAGはモデルの重みを変更せず、回答生成時に外部データを参照する(出典: ntt.com)。RAGは追加学習のステップを省略し、質問時に関連情報を同時に提供することで独自情報を踏まえた回答を可能にする手法とされる(出典: hitachi-solutions.co.jp)。
情報の更新頻度が高い場合、ファインチューニングは再学習のコストと時間がかかるため不向きである。RAGはデータベース側の文書を更新するだけで最新情報に対応できるため、社内ドキュメントや価格情報など変化の多いデータの活用に適している。両者は排他的な関係ではなく、基礎知識をファインチューニングで補い、最新情報や個別情報をRAGで補完するという併用も行われる。
LLMOでRAGのチャンク設計が重要な理由は?
LLMOにおいてチャンク設計が重要なのは、文書の分割方法が検索精度と回答の正確さを直接左右するためである。チャンクとは検索対象として文書を分割した単位であり、分割が粗すぎると無関係な情報が混入し、細かすぎると文脈が失われて意味を正しく検索できなくなる。RAGは検索フェーズで取得した情報をプロンプトとの関連性でランキングして生成フェーズに渡すため(出典: ntt.com)、チャンク自体の質が低いとランキング上位に来る情報の精度も落ちる。
一般的にチャンクサイズは数百文字程度から検討されることが多いが、見出しごとの意味のまとまりを保つ分割や、チャンク間に一定の重複(オーバーラップ)を持たせる設計も文脈欠落を防ぐ手法として知られる。AI検索サービスがウェブページを引用・要約する際も同様の仕組みが働くため、自社サイトが実際にどのプラットフォームでどう引用されているかを継続的に把握することが対策の起点になる。例えば「AIOプレス」はChatGPT・Gemini・Google AI Overviews・AIモード・Claude・Perplexityの6プラットフォームでの言及・引用状況を毎日計測し、引用されていない箇所を自動検出した上で対策記事の生成・公開まで行うサービスであり、こうした計測と改善のサイクルを人手をかけずに回したい場合の選択肢の一つになる。
RAGにはどんな限界・課題があるのか?
RAGの主な限界は、参照する知識ベースの品質にAIの回答精度が依存する点である。知識ベースの記録が曖昧だったり矛盾する情報が含まれていたりすると、AIが正確な情報を得られず回答が混乱する問題が指摘されている(出典: qiita.com)。検索段階で誤った、あるいは無関係な文書を取得してしまうと、生成段階の回答もそれに引きずられて不正確になる。
またRAGを導入しても、検索対象のデータが古い、あるいは網羅性が不足していれば最新情報を反映できない点は変わらない。AWSの定義でもRAGは大規模言語モデルの出力を最適化するプロセスであり、応答生成前にトレーニングデータ以外の信頼できる知識ベースを参照する仕組みとされている(出典: aws.amazon.com)。裏を返せば、参照先の知識ベースを継続的にメンテナンスし、信頼できる情報に保つ運用が前提となる技術である。
参考情報
この記事は次の情報源を参考に、2026年8月時点の情報で作成しています。
・【生成AI入門】「RAG」をできるだけわかりやすく解説してみる #Python - Qiita(qiita.com) ・RAG(検索拡張生成)とは?意味・定義 | IT用語集 | NTT docomo Business Watch | NTTドコモビジネス 法人のお客さま(ntt.com) ・生成AIにおけるRAG(検索拡張生成)とは? 仕組みや活用例をご紹介 | 活文 | 日立ソリューションズ(hitachi-solutions.co.jp) ・RAG とは何ですか? – 検索拡張生成 AI の説明 – AWS(aws.amazon.com) ・RAG(検索拡張生成)とは?従来の生成AIとの違いや活用例を解説 |HelpfeelのFAQお役立ち情報(helpfeel.com) ・【最新】AIO対策会社おすすめ比較|選び方、料金相場を徹底解説!(geo-code.co.jp) ・AIO対策の料金と相場を完全解説──失敗しない会社選びと予算術のコツ | Digital Port(axone.co.jp)
よくある質問
Q. RAGとは何か、わかりやすく言うとどういう仕組みですか?
RAGは「Retrieval-Augmented Generation(検索拡張生成)」の略で、AIが回答を作る前に外部の文書やデータベースから関連情報を検索し、その内容を参考にしながら回答を生成する仕組みである(出典: qiita.com)。「学習済みの知識だけで答える」のではなく「必要な資料を都度確認しながら答える」イメージに近い(出典: helpfeel.com)。
Q. RAGはなぜ必要とされているのですか?
従来のLLMは学習時点で知識が固定され、更新にはファインチューニングなどの追加学習が必要だった。RAGはリアルタイムで外部情報を取得できるため、最新情報や学習データにない独自情報にも対応できる点が求められている理由である(出典: ntt.com)。
Q. RAGとファインチューニングはどう違いますか?
ファインチューニングはモデルの重み自体を追加学習で書き換えるのに対し、RAGはモデルの重みを変更せず回答生成時に外部データを参照する。RAGは追加学習のステップを省略できる点が異なる(出典: hitachi-solutions.co.jp)。
Q. RAGを導入するとどんなメリットがありますか?
学習データにない最新情報や社内固有の情報を回答に反映でき、再学習の手間なくデータベース側の更新だけで情報を最新に保てる点がメリットである。回答の根拠文書を提示しやすいため、情報源の透明性を確保しやすい点も利点である。
Q. RAGにはどのような活用例がありますか?
社内ルールを検索するAIチャットボット、カスタマーサポートでの顧客対応、ヘルプデスクサービスなどが代表的な活用例として挙げられる(出典: hitachi-solutions.co.jp)。
Q. RAGにはどんな限界やデメリットがありますか?
参照する知識ベースの記録が曖昧だったり矛盾していたりすると、AIが正確な情報を得られず回答が混乱する点が限界として指摘されている(出典: qiita.com)。検索段階で誤った文書を取得すると、生成される回答自体も不正確になる。